retour
INGÉNIERIE

Yashraj Singh
Ingénieur IA, Morphic
8 min de lecture

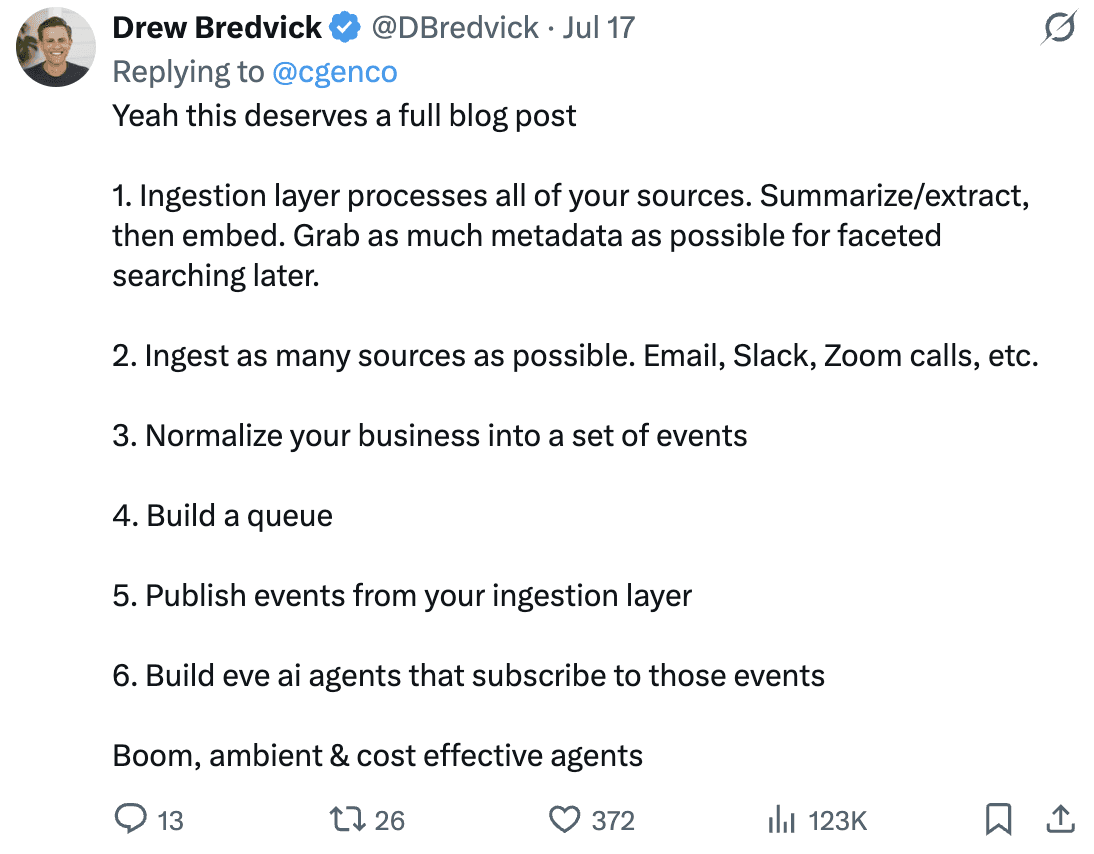
Récemment, notre PDG, Joshua, a partagé un tweet sur Slack de @DBredvick sur X présentant une architecture de pipeline d'ingestion en six étapes. Cela m'a plongé dans une profonde réflexion, et j'ai fini par écrire toute l'histoire de la façon dont nous avons réellement construit la nôtre chez @morphic.io, l'architecture que nous avons choisie, les sources qui sont en production aujourd'hui pour l'ingestion, et les itérations que nous avons faites au fil du temps.
Introduction - Le problème que personne ne veut exprimer à haute voix
Tous les CRM de la terre partagent le même secret inavouable : il est vide parce qu'un être humain doit le remplir.
Pas vide de lignes. Vide de vérité. L'opportunité indique « Proposition » parce que quelqu'un l'a mise à jour il y a trois semaines avant de partir en vacances. La fiche contact contient un nom, une adresse e-mail et rien d'autre. La note qui comptait vraiment – « ils craignent que la migration ne prenne six mois » – dort dans la boîte de réception de quelqu'un, dans une réponse, un mardi, ignorée par le système qui est censé être la mémoire de l'entreprise.
Pendant ce temps, le travail a déjà eu lieu. Il s'est fait dans Gmail. Il s'est fait dans un canal Slack. Il s'est fait lors d'un appel qui a été transcrit puis n'a plus jamais été relu. L'information existe. Elle est simplement dispersée à travers douze outils qui ne communiquent pas entre eux, et dont la seule intégration repose sur la saisie manuelle d'un humain.
Alors nous avons posé la question évidente : et si le CRM se remplissait tout seul ? Et c'est là que nous avons compris pourquoi personne ne l'avait fait jusqu'ici.
Chapitre 1 - L'économie de l'ingestion globale
Prenez un client type de dix personnes. Voici à peu près ce qu'il génère en une seule journée :
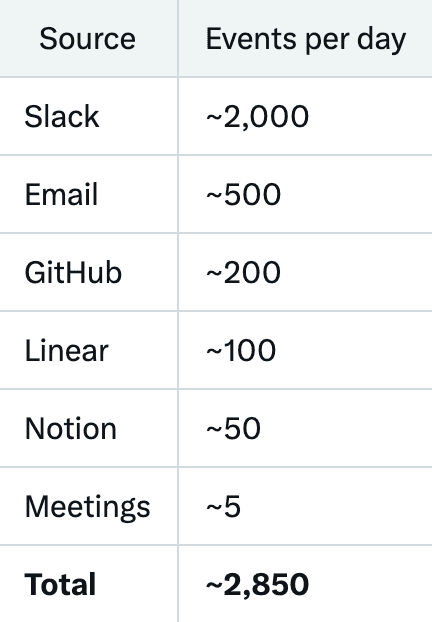
La conception naïve consiste à : orienter une IA vers tout cela. La laisser tout lire et maintenir le CRM à jour.
Faites le calcul. 2 850 événements par jour, chacun nécessitant un contexte réel pour être compris, passés au crible d'un modèle de pointe :
≈ 470 $ par jour. ≈ 14 100 $ par mois. Par client.
Nous vendons le produit entre 1 000 $ et 2 500 $ par mois. Ainsi, la version naïve fait perdre environ douze mille dollars par client, par mois, et en fait perdre d'autant plus vite que le client réussit.
Et l'intégration est encore pire. Un nouveau client connecte deux ans de Gmail - soit environ 200 000 messages. Lire tout cela avec l'IA pour reconstituer son historique :
≈ 33 000 $. Pour un seul client. Dès le premier jour. Avant même qu'il ne vous ait payé quoi que ce soit.
Ces chiffres proviennent de notre propre charge de travail en production, pas d'une loi universelle - un client qui utilise beaucoup Slack ou les e-mails modifiera le multiplicateur. Mais la forme du problème ne change pas : l'intégration naïve fait augmenter les coûts proportionnellement au volume, et le volume augmente proportionnellement à la réussite du produit.
C'est à ce moment-là que la plupart des équipes réduisent discrètement leurs ambitions. Elles déploient un bouton « résumer cet e-mail par l'IA » et appellent cela une plateforme.
Nous ne voulions pas faire cela. Ainsi, l'ensemble du pipeline - chaque décision de conception dans cet article - existe pour anéantir ces deux chiffres sans pour autant sacrifier l'ambition.
Là où nous en sommes arrivés
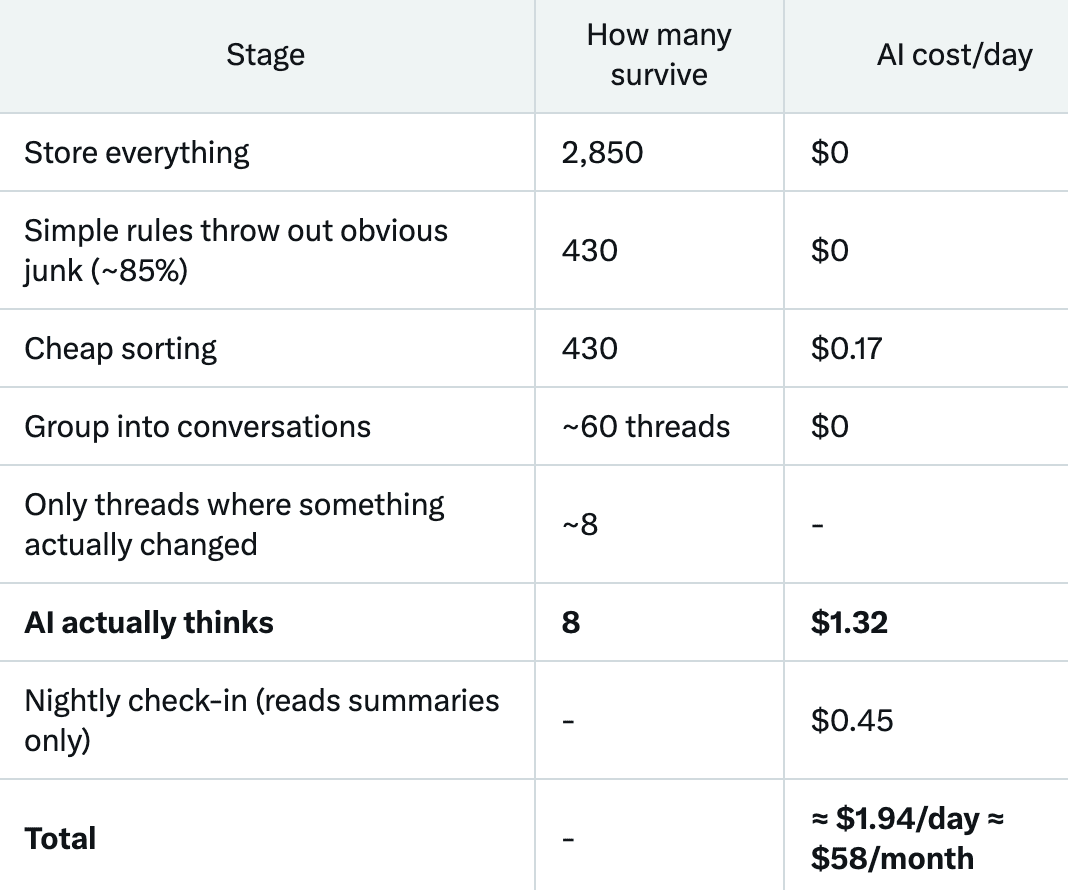
14 100 $ → 58 $. Environ 240 fois moins cher. Récupération de l'historique : 33 000 $ → environ 85 $.
Il ne s'agit pas d'une astuce ou d'un raccourci. C'est un modèle bien connu - les recherches FrugalGPT de Stanford ont montré que les cascades « d'abord bon marché, escalade rare » permettaient d'obtenir jusqu'à 98 % de réduction des coûts pour une précision identique. Nous l'avons simplement appliqué sans pitié.
Chapitre 2 - Le principe
Nous avons passé beaucoup de temps à débattre d'une fausse question : devons-nous tout ingérer, ou seulement les choses importantes ?
Les deux réponses sont fausses, et le débat ne s'est terminé que lorsque nous avons divisé la question en deux :
Soyez généreux avec les faits. Soyez stricts avec les engagements.
Les faits sont des choses qui se sont simplement produites. Une personne existe. Une entreprise existe. Un e-mail a été envoyé mardi à 16h. Une réunion a eu lieu. Ceux-ci sont peu coûteux, ils sont sûrs, et plus il y en a, plus le système est intelligent. Collectez-les tous.
Les engagements sont des choses qui font agir le système. Créer une opportunité. Changer d'étape. Réserver quelque chose. Rédiger un message sortant. Ceux-ci sont coûteux, et - ce qui est bien plus important - un seul engagement erroné brise définitivement la confiance. Si le CRM invente une opportunité appelée "DocuSign" parce que quelqu'un a signé un contrat via DocuSign, l'utilisateur ne croit plus rien de ce qu'il lui dit. Contrôlez-les rigoureusement.
Cette seule phrase a résolu des mois de débat entre "données inutiles ou exhaustivité". Nous sommes généreux au bas de l'entonnoir et stricts au sommet, et les deux n'entrent plus jamais en conflit. Tout ce qui suit n'est que la mise en œuvre de cette phrase.
Chapitre 3 - Aperçu de l'architecture
Chapitre 4 - L'ingestion brute (Étage 1 : le service du courrier)
Chaque événement de chaque connecteur est stocké, exactement tel qu'il est arrivé, pour toujours. Nous l'enveloppons dans une étiquette standard, prenons une empreinte numérique du contenu afin de ne jamais stocker deux fois la même chose, remettons une copie au bibliothécaire pour indexation, et nous nous arrêtons là.
Cette étiquette - l'enveloppe dans laquelle chaque événement est emballé, quelle que soit sa source - ressemble à peu près à ceci :
Zéro IA. Zéro décision. Zéro jugement.
Ce niveau semble ennuyeux et c'est pourtant le plus important du bâtiment, pour une seule raison : chaque niveau supérieur est calculé à partir de lui. Si jamais nous faisons une erreur de règle - un filtre trop agressif, une catégorie mal étiquetée, une décision de conception entière annulée - nous n'avons rien perdu. Nous la réexécutons.
C'est cette propriété qui a permis d'affirmer des opinions tranchées partout ailleurs en toute sécurité. Nous pouvons nous tromper, et nous rétablir, sans avoir à dire à un client que ses données ont disparu.
Chapitre 5 - Traitement déterministe (Étage 2 : le trieur)
Deux tâches, toutes deux effectuées par des machines stupides. Délibérément, fièrement, sans aucune IA.
Tâche A : jeter les spams évidents. Pas par mots-clés - les filtres par mots-clés sont réputés pour ne pas être fiables et génèrent exactement le genre de ticket d'assistance « pourquoi mon e-mail important a-t-il été englouti ». Par la structure, qui elle ne ment pas :
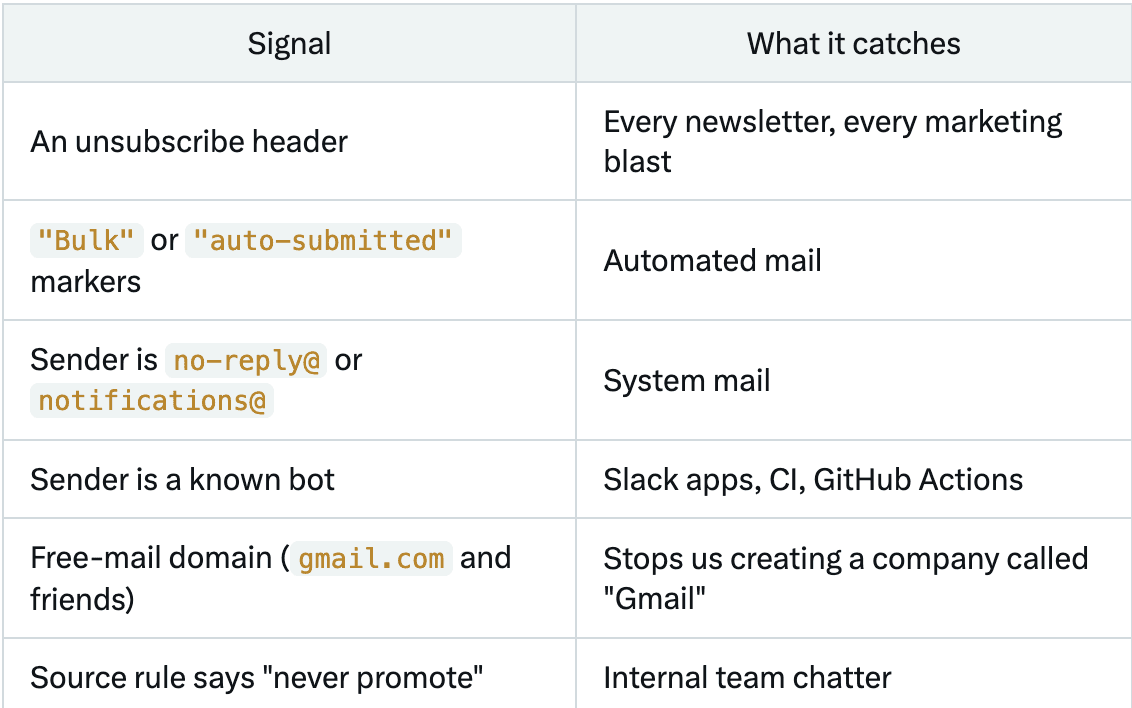
Cela élimine environ 85 % de tout le volume à un coût nul. C'est la victoire la plus simple et la moins chère de tout le système, et c'est la solution pour les enregistrements indésirables qui nous faisaient honte lors des démos.
Point crucial : ces filtres contrôlent la promotion, jamais le stockage. Une newsletter filtrée se trouve toujours dans la boîte de réception, toujours consultable. Nous décidons de ce qui est traité, pas de ce qui est conservé.
Tâche B : identifier qui sont les gens. Lorsque sarah@morphic.io apparaît, s'agit-il d'une personne que nous connaissons déjà ? C'est un problème véritablement difficile, et nous l'avons résolu grâce à une échelle de décision, en commençant par le barreau le moins cher :
Restreindre le champ d'action. Ne la comparez qu'aux personnes se trouvant dans le même groupe : même domaine d'e-mail, nom à la consonance similaire. Sans cela, chaque nouvelle personne est comparée à chaque personne existante, et le système s'effondre à mesure que le portefeuille clients grandit.
Correspondance exacte. Même e-mail, téléphone ou identifiant ? C'est elle. Précis à environ 99 %, et gratuit.
Correspondance floue (fuzzy). « Jon Smyth » et « John Smith » sont probablement la même personne. Une évaluation standard de la similarité des chaînes de caractères, toujours gratuite.
Alors seulement, demander à l'IA - pour les 2 à 5 % véritablement ambigus. Et nous mettons la réponse en cache pour toujours, de sorte que la même paire déroutante ne soit jamais évaluée deux fois.
Chapitre 6 - La couche de connaissances (Étage 3 : le bibliothécaire)
Pour chaque élément important - un client, une affaire, une personne - nous tenons une page de résumé vivante. Pas l'historique brut. Un condensé de « voici ce qui se passe. »
Pourquoi un résumé plutôt que de lire l'historique brut à chaque fois ? Parce que répondre à « comment va Morphic ? » en lisant 500 messages est lent et coûteux, tandis qu'y répondre à partir d'une seule courte page est instantané et presque gratuit. Écrivez-le une fois, lisez-le cent fois.
La page n'est réécrite que lorsque quelque chose de réel se produit. Il y a exactement cinq déclencheurs :

Chapitre 7 - La frontière de l'IA (Étage 4 : le détective)
C'est la partie coûteuse et intelligente, et elle ne s'exécute presque jamais.
Lorsqu'elle s'exécute, elle ne lit pas l'historique brut – elle lit les pages de résumé du Bibliothécaire et la carte de qui-connaît-qui. Si cela ne suffit pas, elle effectue une recherche. Si cela ne suffit toujours pas, elle va chercher les informations en direct à la source. Trois niveaux, du moins cher au plus cher, le même modèle que partout ailleurs :
Chaque fonctionnalité tape-à-l'œil que les gens demandent – briefings d'avant-réunion, rapports d'après-réunion, « quels contrats sont au point mort », fiches de veille concurrentielle – s'avère être une question posée aux pages de résumé. Aucun nouveau pipeline n'est nécessaire pour l'une d'entre elles. C'est à ce moment-là que nous avons su que la structure était la bonne.
Chapitre 8 - Routage des connecteurs à grande échelle
Voici un piège dans lequel nous avons bien failli tomber.
Nous n'avons pas seulement besoin de Gmail. Nous avons besoin de Slack, Calendar, Telegram, d'appels téléphoniques, d'enregistreurs de réunion, de Notion, GitHub, Linear, HubSpot, Salesforce, d'outils marketing, et d'une longue liste de centaines d'autres.
Premier piège : écrire un pipeline personnalisé par connecteur. Vous n'en finiriez jamais. Vous feriez du travail d'intégration indéfiniment et chaque nouvelle source prendrait un trimestre de temps d'ingénierie.
Deuxième piège : forcer tout le monde à adopter un format partagé rigide. Ensuite, chaque fois qu'une source modifie ses données, tout ce qui se trouve en aval s'effondre d'un coup.
La réponse que nous avons trouvée : normaliser l'étiquette, conserver le colis.
Pensez à l'envoi d'un colis. Chaque colis reçoit la même étiquette d'adresse à l'extérieur. Ce qui se trouve à l'intérieur de la boîte reste exactement tel quel. L'étiquette est identique pour chaque connecteur, pour toujours : quel client, quelle source, leur identifiant, une empreinte numérique du contenu, quand cela s'est produit, à quelle conversation cela appartient, qui était impliqué, s'il s'agissait d'un message entrant ou sortant, et qui est autorisé à le voir. Ensuite, le contenu original, intact.
Et chaque connecteur reçoit une ligne de configuration - et non du code - décrivant comment le traiter :
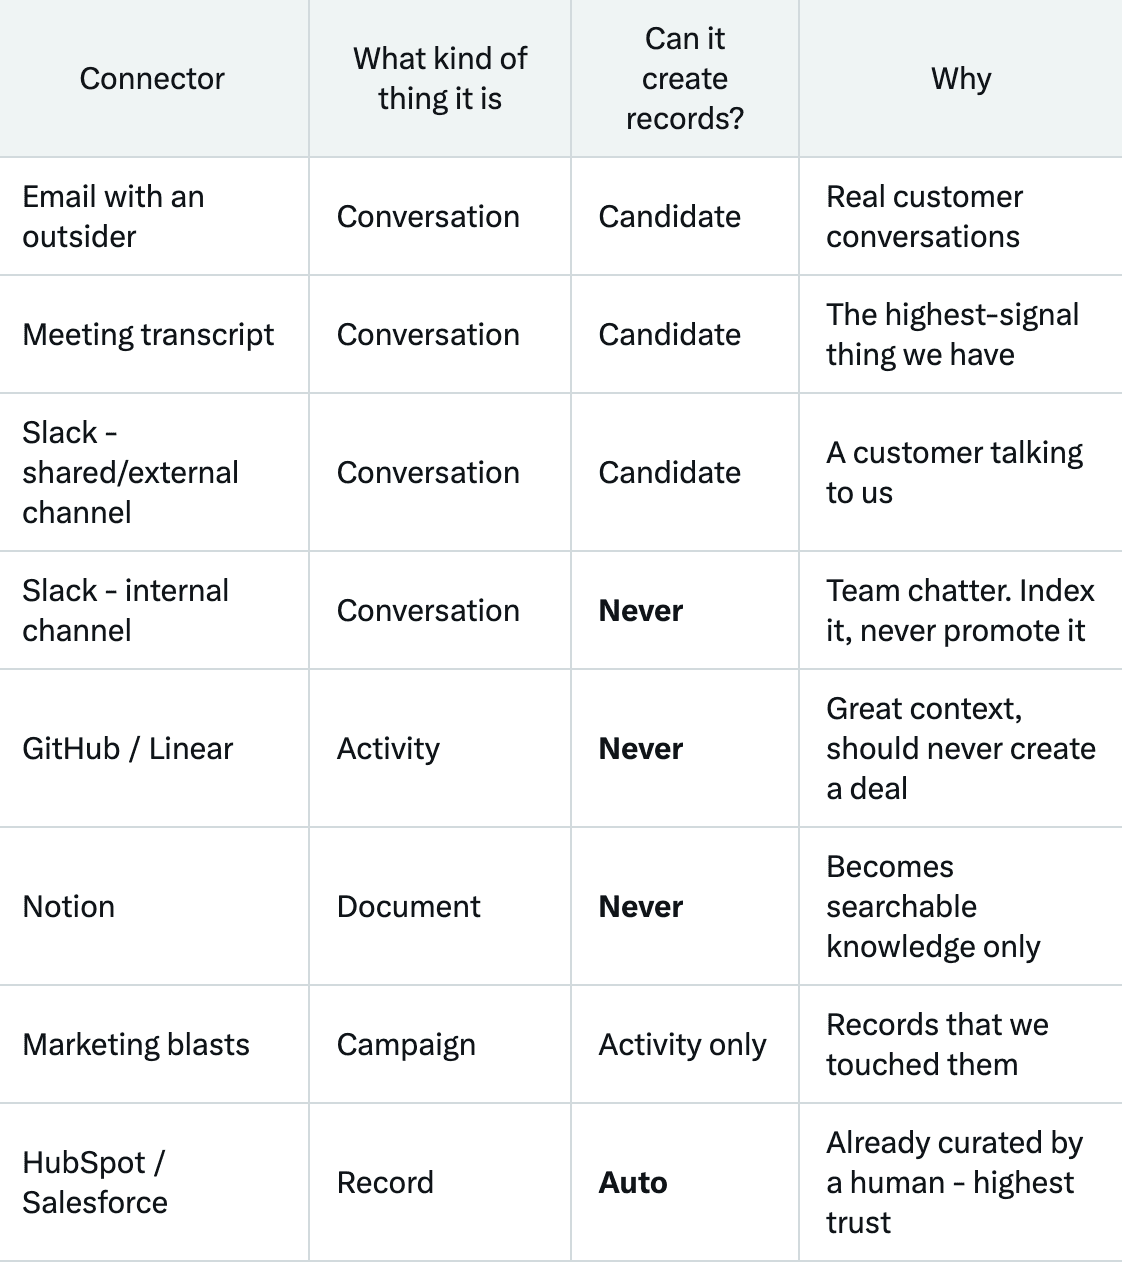
Ajouter un nouveau connecteur consiste à ajouter une ligne de configuration, et non à écrire un nouveau pipeline.
Regardez ce que ce tableau élimine instantanément : deux mille messages Slack internes par jour n'atteignent jamais l'étape coûteuse (mais restent entièrement consultables). Le bruit de la CI ne crée jamais de transaction. Un outil de marketing ne fabrique jamais cinq mille faux contacts.
Chapitre 9 - Ingestion indépendante du schéma
C'est celui-ci qui a fait échouer toutes les versions précédentes, et cela vaut la peine de l'expliquer car c'est là toute la différence entre un outil de vente et une plateforme.
Notre CRM n'a pas de tables fixes. Les clients définissent leurs propres objets. Ainsi, un vrai client peut avoir des Investisseurs, Mentors, Employés, Partenaires de Lancement, Fournisseurs, Partenaires Offshore et Amis du PDG - et aucune "Entreprise" ni aucun "Deal" nulle part. Un hôtel a des Clients, des Propriétés et des Réservations. Une école a des Élèves, des Écoles et des Inscriptions.
Donc : un e-mail arrive. Où va-t-il ? Un pipeline qui code en dur "Entreprise / Personne / Deal" est inutile pour tous ces clients.
Le constat clé
Le pipeline ne doit jamais savoir ce qu'est une "Entreprise".
Mais voici ce que nous avons remarqué : quel que soit le modèle économique que nous avons fait passer par ce pipeline jusqu'à présent, peu importe comment ils nomment les choses, tout se réduit à cinq formes :
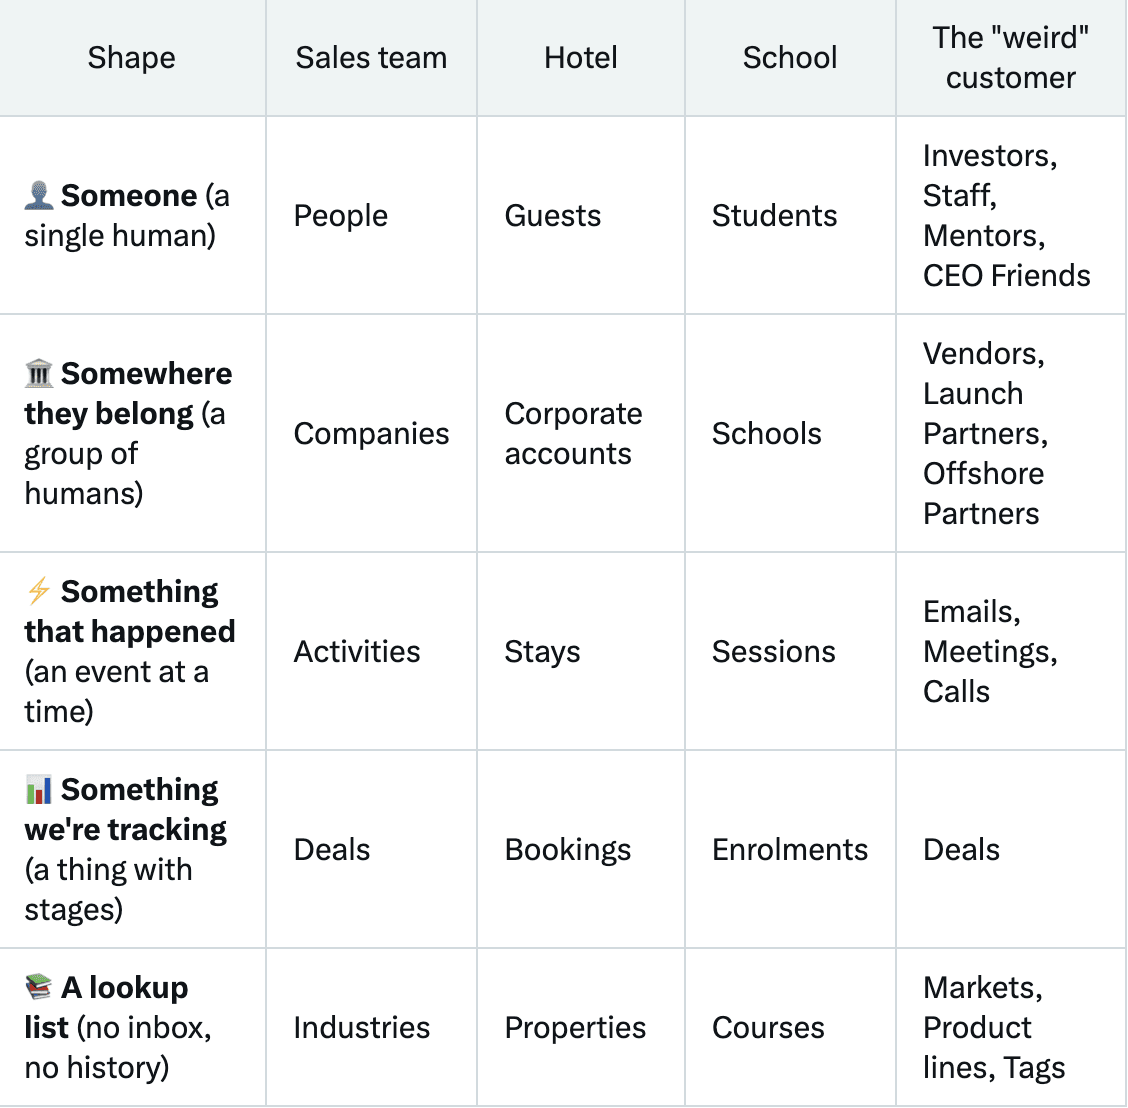
Même pipeline. Même code. Des entreprises radicalement différentes.
L'astuce qui rend le tout économique
L'IA est utilisée pour comprendre la forme de l'entreprise - une seule fois. L'IA n'est jamais utilisée pour acheminer chaque message individuel.
Quand quelqu'un crée un objet appelé "Partenaires de Lancement", nous passons un seul appel d'IA : laquelle des cinq formes est-ce ? Réponse : c'est un groupe d'humains. Cette réponse est sauvegardée de manière permanente sur l'objet.
Après cela, chaque e-mail qui arrive pour toujours est une simple recherche directe. Pas d'IA. Pas de réflexion. Pas de coût.
Dix appels d'IA sur toute la durée de vie d'un espace de travail, au lieu de cinq cents par jour. Et un administrateur peut modifier la suggestion - nous ne faisons pas aveuglément confiance à une classification automatique.
Et si plusieurs objets partagent une même forme ?
Cas réel : les Investisseurs, Mentors, Employés et Amis du PDG sont tous "un humain unique". Un e-mail arrive de sarah@morphic.io. Où va-t-elle ?
Même logique, l'option la moins chère d'abord :
Existe-t-elle déjà quelque part ? Placez-la là. Gratuit.
Existe-t-il une règle d'acheminement ? ("Les domaines de notre liste de capital-risque vont vers les Investisseurs.") Acheminez-la. Gratuit.
Y a-t-il une valeur par défaut pour cette forme ? Placez-la là, marquée comme non classée. Gratuit.
Rien de tout cela ? Elle attend dans une zone de transit. L'IA la classera plus tard - et uniquement s'il s'avère qu'elle a de l'importance.
Elle n'est jamais perdue, jamais bloquée et son classement ne coûte jamais un seul jeton. Si elle devient importante, elle est déplacée une fois. Et un humain peut toujours corriger le tir.
Et si l'espace de travail est complètement vide au premier jour ?
C'est la propriété de sécurité qui rend tout le reste possible :
Le service du courrier et le bibliothécaire n'ont pas de schéma. Seul le CRM en a un. Ainsi, le pipeline ne bloque jamais et ne perd jamais de données tant que le schéma n'est pas encore défini.
Les données arrivent dès la première minute et sont immédiatement consultables. Les dossiers qui n'ont nulle part où aller attendent dans une zone de transit. Ensuite, soit le client choisit un modèle sectoriel, soit - après quelques jours - nous passons un seul appel d'IA qui analyse l'ensemble des tendances et propose :
"Vous semblez vous adresser à des hôtels et prendre des réservations. Dois-je créer Clients, Propriétés et Réservations ?"
Un humain accepte. Les objets sont créés. Tout ce qui était en attente est intégré automatiquement.
C'est un CRM qui se construit tout seul, et cela coûte un seul appel d'IA - pas un par message.
Et les étapes ne sont jamais codées en dur
Une version initiale du pipeline créait toujours les opportunités à l'étape "prospection". C'est un problème pour un hôtel, où une réservation commence par "demande de renseignement", et pour une école, où une inscription commence par "dossier déposé".
La solution : lire les étapes en direct à partir de ce que le client a réellement configuré, et choisir parmi celles-ci. Même code, zéro codage en dur :
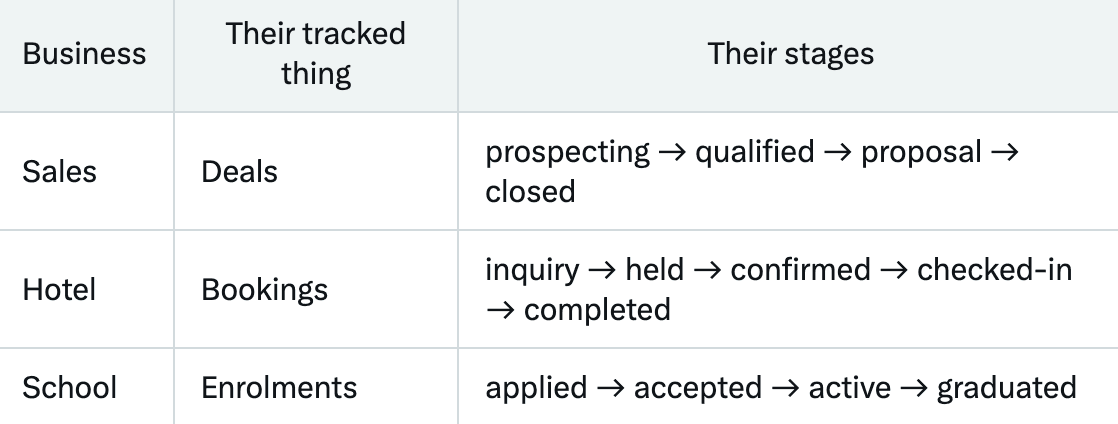
Et si nous nous trompons dans l'association d'une forme ?
Il suffit de la reconstruire. Les synthèses sont dérivées du service du courrier, donc modifier l'association et relancer le processus déplace les dossiers au bon endroit. Rien n'est perdu.
C'est aussi la réponse à la question "et si le client change de modèle économique l'année prochaine ?" - le système réanalyse gratuitement tout ce qui s'est déjà produit, car nous n'avons jamais rien jeté.
Chapitre 10 - La porte de promotion
Il y a une décision dans tout ce système qui mérite sa propre section, car c'est là que la confiance se gagne ou se perd : quand créons-nous un enregistrement ?
L'ancienne réponse était par message et c'était terrible. Un simple e-mail aux allures commerciales créait une opportunité. C'est ainsi que l'on se retrouve avec une opportunité nommée d'après un service de signature de documents, et un utilisateur qui ne fera plus jamais confiance au produit.
La nouvelle réponse est par conversation, et déterministe. Après chaque nouveau message dans un fil de discussion, un minuteur est lancé. Lorsque la conversation s'apaise, nous posons quelques questions simples et ennuyeuses :
Les deux parties ont-elles réellement parlé ? (Bidirectionnel, pas un envoi de masse)
Y a-t-il quelqu'un d'extérieur à l'entreprise ?
Y a-t-il eu assez d'échanges pour que ce soit sérieux ?
Est-ce que cela semble concerner une affaire commerciale ?
Si oui - et seulement si oui - nous créons un enregistrement, une seule fois, pour l'ensemble du fil de discussion. Pas un par message. Pas trois opportunités pour trois réponses.
Environ 97 % des conversations s'arrêtent à cette étape, n'ayant rien coûté tout en restant entièrement consultables pour toujours. Environ 3 % bénéficient d'une véritable analyse intelligente.
Ce ratio constitue l'intégralité du modèle économique.
Une autre subtilité qui mérite d'être soulignée : nous n'avons délibérément pas remplacé quarante vérifications peu coûteuses par un seul appel d'IA intelligent par fil de discussion. Cela aurait été moins cher que l'ancienne conception, mais cela resterait une mauvaise architecture — cela dépense de l'argent pour la création automatique d'enregistrements, qui est précisément ce qui doit rester conservateur. La barrière déterministe ennuyeuse fait déjà ce travail, et elle le fait de manière prévisible.
Chapitre 11 - Autorité humaine et provenance
Cela fait passer Morphic à « Négociation ». C'est une erreur.
Le message Slack est l'interface de correction. Joshua clique sur [Annuler]. L'ancienne valeur réapparaît, et ce champ est définitivement marqué comme appartenant à un humain. À partir de ce moment, l'IA ne touche plus jamais à ce champ.
Chaque champ écrit automatiquement comporte trois éléments : qui l'a écrit, quel était le niveau de confiance et sur quels événements spécifiques il s'est basé. Les modifications humaines l'emportent sur les modifications de la machine, de manière permanente, avec une piste d'audit.
Nous pensons que cela n'est pas négociable. Un système automatisé qui ne peut pas être corrigé n'est pas un produit, c'est un risque.
La même règle s'applique un niveau au-dessus, au schéma lui-même : le système ne peut concevoir et gérer le schéma que tant qu'aucun humain n'y a touché. Dès qu'une personne crée ou modifie un type d'objet, la propriété du schéma est transférée à l'humain, de manière définitive.
Chapitre 12 - Douze histoires
Voici à quoi ressemble concrètement la journée d'un client.
Scénario 1 - Un nouveau prospect vous contacte par e-mail (celui qui se passait mal auparavant)
Sarah de Morphic envoie un e-mail à Josh concernant les tarifs. Josh répond. Sarah répond.
Mailroom : les trois messages sont stockés et reçoivent une empreinte numérique.
Sorter : pas d'en-tête de désinscription, ce n'est pas un bot → le message passe.
devient une Entreprise. Sarah devient une Personne. Une activité est enregistrée pour chaque message, immédiatement. Tout est déterministe. Aucune IA n'a encore été sollicitée, et il n'y a pas encore d'opportunité créée.
Gate : une fois que le fil de discussion se stabilise - bidirectionnel, externe, trois échanges, au format professionnel - il se déclenche une seule fois.
Record : une opportunité est créée. Son étape est définie à partir de la configuration en direct du client. Le commentaire de Sarah sur le budget, son inquiétude concernant la migration et la promesse de Josh d'envoyer un document tarifaire sont mappés dans les champs réels de l'opportunité.
Slack : "Création de Morphic - Tarifs (Découverte). Sarah est la championne. Point de vigilance identifié sur la migration. [Annuler] [En réalité, c'est...]"
Total des opportunités créées : 1. Total des appels IA pour l'ensemble du fil : 1.
Scénario 2 - Discussions Slack internes
Vingt messages dans
concernant le pipeline de déploiement. Stockés, indexés, consultables à vie. La règle source stipule que le Slack interne ne crée jamais d'enregistrements, de sorte que la validation (gate) court-circuite immédiatement le processus. Zéro IA. Zéro enregistrement. Zéro coût. Mais si l'on demande, trois mois plus tard : « qu'avons-nous décidé concernant ce changement de déploiement ? », l'information est retrouvée instantanément.
Scénario 3 - Un client crée un ticket GitHub (le cas magique)
Sarah de Morphic ouvre un ticket dans notre dépôt. GitHub ne crée jamais d'enregistrements CRM – c'est une règle absolue. Mais le Sorter reconnaît tout de même son e-mail GitHub comme étant celui de cette même Sarah. La cartographie connecte désormais Morphic → Sarah → ce ticket. Ainsi, la prochaine fois que Josh demandera « quel est le statut de Morphic ? » :
"L'opportunité est en phase de Découverte - et pour info, Sarah a signalé un bug sur le flux d'importation il y a deux jours. Toujours ouvert."
GitHub n'a rien créé. Il a simplement rendu la réponse plus intelligente. C'est exactement ce que signifie « intégrer l'ensemble de vos outils ».
Scénario 4 - Un hôtel reçoit une demande de réservation (aucune « opportunité » nulle part)
maria@gmail.com envoie un e-mail pour se renseigner sur les chambres disponibles en août.
Domaine de messagerie gratuit → aucune entreprise créée. C'est correct : il s'agit d'un particulier, pas d'une organisation.
Maria est enregistrée dans l'objet Clients (Guests) de l'hôtel.
Échange bidirectionnel → la validation (gate) se déclenche.
Le pipeline recherche « l'élément que cette entreprise suit par étapes », trouve Réservations (Bookings), lit ses véritables étapes, et crée une réservation au statut demande d'information.
Slack : "Nouvelle demande de réservation de Maria, du 22 au 25 sept. [Confirmer] [Modifier]"
Même pipeline. Même code. Le mot « opportunité » n'apparaît nulle part.
Scénario 5 - L'opportunité devient inactive (il ne se passe rien - et c'est tout l'intérêt)
Aucun événement ne se déclenche. Personne n'envoie d'e-mail. C'est précisément là le problème. L'analyse nocturne lit uniquement les pages de résumé - jamais l'historique brut - et remarque que Morphic est silencieux depuis douze jours tout en restant en phase de Découverte :
"Morphic est inactif depuis 12 jours. Le dernier sujet évoqué par Sarah concernait l'effort de migration, et le document n'a jamais été envoyé. Voulez-vous que je prépare un e-mail de relance ?"
C'est la fonctionnalité de « rappel discret » que tout le monde recherche, et elle ne coûte que quelques centimes par jour pour un client entier, car elle lit des résumés au lieu de l'historique complet.
Scénario 6 - L'IA se trompe (l'humain a toujours le dernier mot)
Elle déplace Morphic en phase de « Négociation ». C'est une erreur. Le message Slack sert d'interface de correction. Josh clique sur [Annuler]. L'ancienne valeur est rétablie, et ce champ est définitivement marqué comme géré par un humain. À partir de ce moment, l'IA ne touche plus jamais à ce champ. Chaque champ rempli automatiquement contient trois informations : qui l'a écrit, quel était le niveau de confiance et sur quels événements précis il s'est basé. Les modifications humaines l'emportent définitivement sur les modifications de la machine, avec une piste d'audit à l'appui. Nous pensons que c'est non négociable. Un système automatisé qui ne peut pas être corrigé n'est pas un produit, c'est un risque.
Scénario 7 - Un tout nouvel espace de travail sans aucun objet (le CRM se construit de lui-même)
Les données arrivent immédiatement dans la Mailroom et l'index - rien ne bloque, rien ne se perd.
Les enregistrements sans destination attendent dans une zone de transit.
Un seul appel IA analyse les modèles globaux et propose un schéma : "Vous échangez avec des hôtels et prenez des réservations → créer Clients, Établissements, Réservations ?"
Un humain accepte. Les objets sont créés, chacun étant automatiquement classé dans l'un des cinq formats.
Tout ce qui était en transit est intégré automatiquement.
Avec un garde-fou sur lequel nous avons insisté : le système ne peut concevoir et gérer le schéma que tant qu'aucun humain n'y a touché. Dès qu'une personne crée ou modifie un type d'objet, la propriété du schéma est transférée définitivement à l'humain. C'est la même règle de la « priorité à l'humain » que dans le Scénario 6, au niveau supérieur.
Scénario 8 - Quatre objets partagent le même format
Décrit ci-dessus : correspondance existante → règle de routage → valeur par défaut → transit. Les données ne sont jamais perdues, jamais bloquées, et leur classement ne coûte aucun jeton.
Scénario 9 - Le client connecte HubSpot
Les données de HubSpot ayant été organisées par un humain, il s'agit de notre source de confiance la plus élevée. Elles ignorent complètement la validation de pertinence et sont provisionnées directement. Plus important encore, les contacts HubSpot fusionnent dans la même carte d'identité que Gmail et Slack. Ainsi, Sarah-de-HubSpot et Sarah-de-Gmail deviennent une seule et même Sarah, et non trois. Et nous avons défini une limite explicite : notre CRM reste toujours le système de référence. Un CRM externe est une cible de synchronisation, jamais un remplacement.
Scénario 10 - Un envoi d'e-mails marketing en masse
Un e-mail de campagne contenant un en-tête de désinscription est écarté avant même de devenir une ligne dans la base de données. Il n'atteint jamais le Sorter, ne crée rien et ne coûte rien. Environ 85 % du volume total s'arrête ici. Les e-mails professionnels légitimes passent. Nous avons vérifié ces deux flux avec du trafic réel.
Scénario 11 - Quelqu'un crée un objet personnalisé
Ils ajoutent « Partenaires de lancement ». Un seul appel IA classifie son format et met la réponse en cache définitivement. Un administrateur peut la remplacer. Chaque futur message est routé par simple recherche directe – zéro IA, pour toujours. Les types intégrés évitent complètement l'IA, car nous savons déjà ce qu'ils sont.
Scénario 12 - Une réunion se termine
La transcription arrive et les actions de suivi sont prêtes. Cela déclenche une réécriture : chaque page de résumé connectée à cette réunion est recompilée, de sorte que la prochaine question « comment va Morphic ? » reflète déjà ce qui s'est dit il y a une heure.
Chapitre 13 - Où cela peut encore échouer
Nous avons écrit cette liste avant l'expédition, pas après.
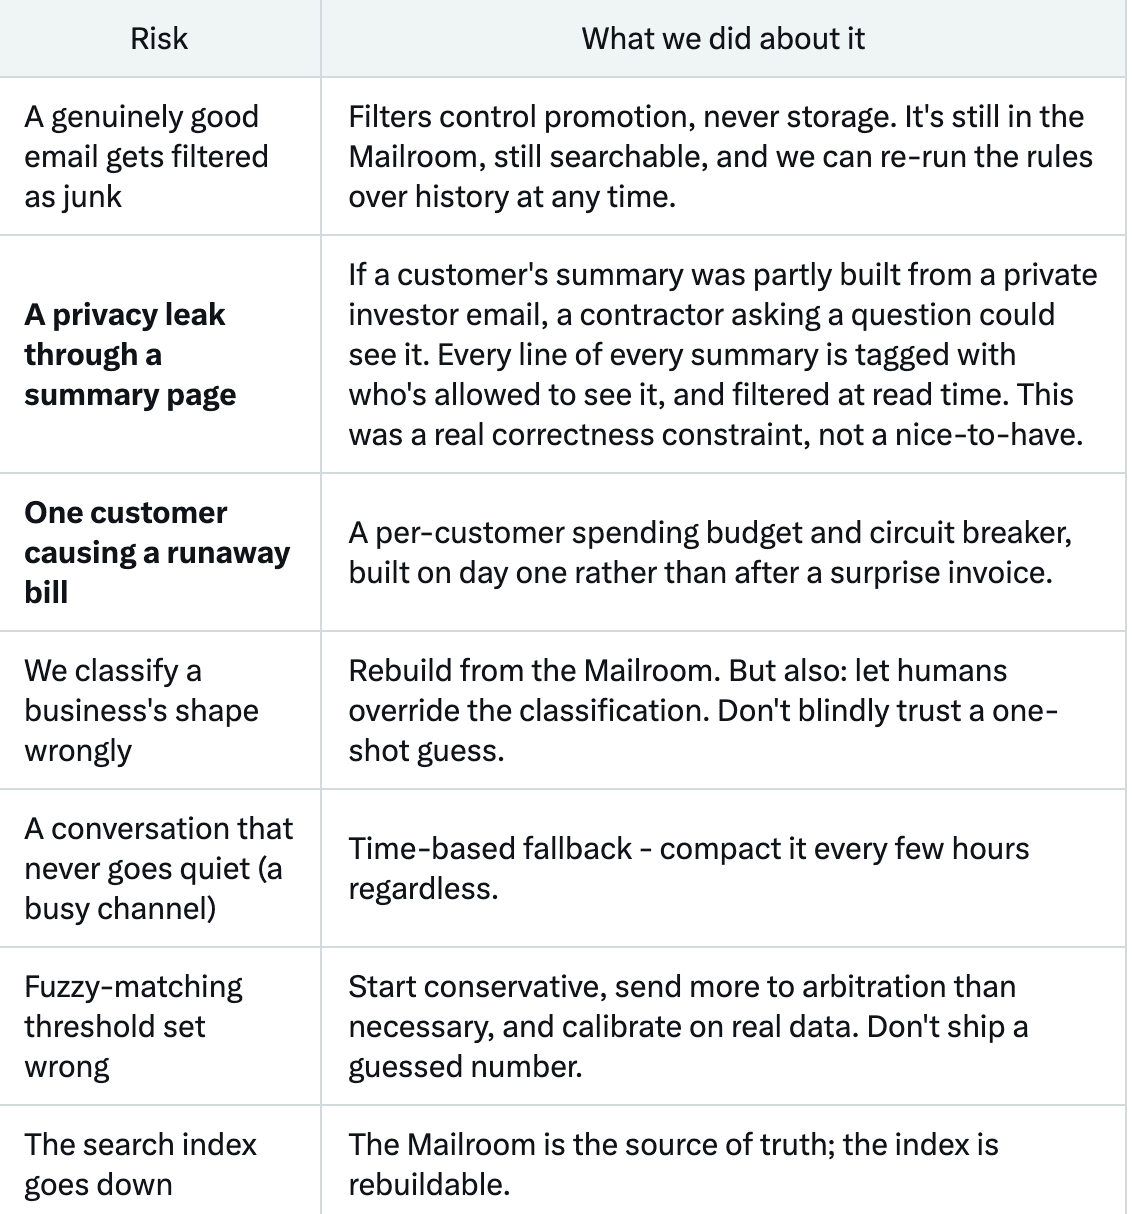
Et la liste honnête de ce qui n'est « pas encore construit » : la double écriture bidirectionnelle vers les CRM externes, et la synchronisation complète pour les enregistrements des CRM externes (aujourd'hui, nous nous appuyons sur la normalisation en amont du connecteur).
Chapitre 14 - Ce que cela représente
Débarrassez-vous des niveaux, des archétypes et des filtres, et l'ensemble repose sur quatre idées :
Conserver tout, pour toujours, sans traitement. Ainsi, aucune erreur en amont n'est permanente, et aucun filtre ne constitue une décision de perte de données.
Faire d'abord ce qui est simple et escalader rarement. Des règles avant les modèles. Des correspondances exactes avant les floues. Des résumés avant l'historique brut. À chaque embranchement, sans exception.
Être généreux avec les faits et strict avec les engagements. Enregistrer tout ce qui s'est passé. Ne créer presque rien automatiquement. Une transaction erronée coûte plus de confiance que cent transactions manquantes.
L'humain gagne toujours. Chaque écriture automatisée est étiquetée avec son auteur et ses fondements, chaque message de livraison est également une surface de correction, et une correction humaine est permanente.
Le résultat est un CRM où les fiches se remplissent d'elles-mêmes, les opportunités discrètes se manifestent d'elles-mêmes, et ce que votre prospect a dit un mardi après-midi concernant le calendrier de migration est toujours là - dans l'opportunité, dans le résumé, dans la réponse - trois semaines plus tard, au moment où cela compte.
Mais ce que nous avons réellement construit n'était pas une fonctionnalité d'IA.
C'était un système qui sait quand ne pas utiliser l'IA.
Conserver les données brutes. Prendre d'abord les décisions simples. Construire le contexte une seule fois et le réutiliser. N'escalader que lorsque le système a quelque chose qui vaut la peine d'être analysé. Et chaque fois que la machine prend une décision, laisser suffisamment de contexte pour qu'un humain puisse la comprendre, la corriger ou l'annuler.
C'est ce qui a fait toute la différence entre greffer un LLM sur un CRM et concevoir un système d'ingestion capable de devenir véritablement la mémoire du CRM.
Et c'est la partie qui m'enthousiasme le plus : plus la couche d'ingestion est performante, moins l'utilisateur a de choses à faire.
Chapitre 3 - Aperçu de l'architecture
La façon la plus simple de garder toute la conception en tête est d'imaginer toutes les informations de votre entreprise comme du courrier arrivant dans un bâtiment de quatre étages.
Toute l'astuce en une phrase : les étages 1, 2 et 3 traitent 100 % de tout. L'étage 4 traite environ 0,3 % de tout. C'est là que réside l'économie de coût. Tout le reste n'est que détail.